BoldVoice AI 音素级实时反馈 · 核心技术详解
普通发音 APP 为什么不够好
你可能用过一些发音 APP,它们的反馈通常是:
- ✅ 正确 / ❌ 错误(二选一)
- 一个笼统的 80 分 / 60 分(但你不知道哪部分没到位)
- 可能录一段音然后告诉你「整体还可以」
这些反馈对于改善发音来说颗粒度太粗了。你需要的是:
- 我读的这个单词里,哪个音素发对了、哪个音素发错了
- 错到什么程度(是有点偏还是完全变成另一个音素)
- 和母语标准的差距在哪个维度(频率?时长?)
BoldVoice 的 AI 做到了这三点。
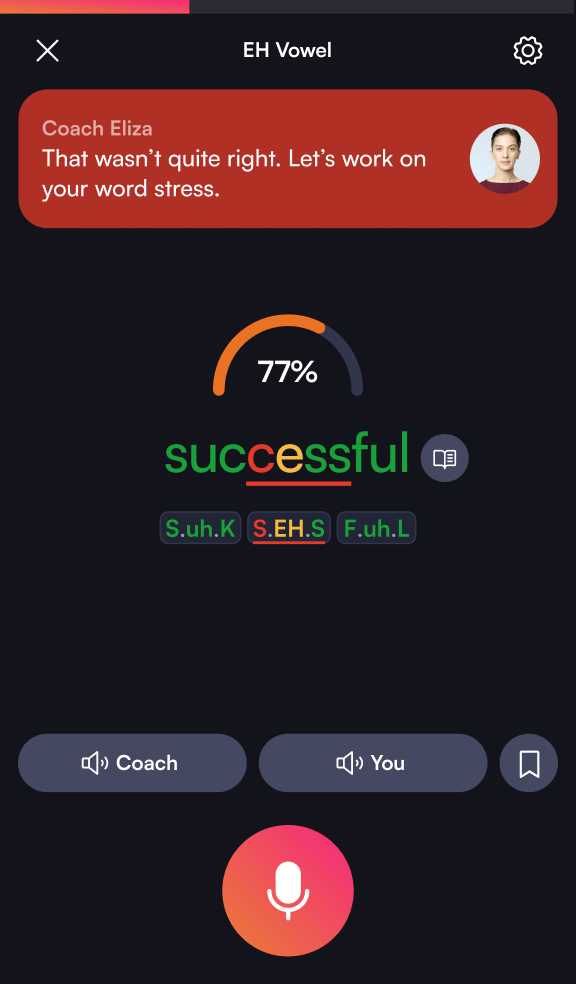
AI 评分的基本原理
BoldVoice 的 AI 技术核心是音素级的 GOP(Goodness of Pronunciation)评分。基本流程:
- 你开口读目标单词或句子
- AI 用 ASR(自动语音识别)模型把你的音频切分成一个个音素片段
- 对每个音素片段,计算它和母语标准发音的相似度
- 相似度转换为 0~100 的准确率分数
- 根据分数映射为颜色(绿 / 黄 / 红)
为什么是音素级而不是单词级
单词级评分会出现一个问题:一个单词可能包含 6 个音素,其中 5 个正确、1 个明显错误。单词级评分可能给你 83 分(看起来还行),但那个错误的音素正是沟通里最可能造成问题的。
音素级评分把这个错误精确暴露出来——你能看到:
- think 里的 /θ/ 得了 42 分(红色)
- think 里的 /ɪ/ 得了 78 分(黄色)
- think 里的 /ŋk/ 得了 94 分(绿色)
这样你就知道重点要改的就是 /θ/,而不是把整个单词当成没问题。
实时性怎么做到的
你一开口,AI 就开始处理了,不需要等你读完整个单词。当你读完一个音素时,前面音素的分数已经出来了。这种实时性靠的是:
- 流式 ASR:音频边录边切分
- 模型轻量化:适合在移动端跑的神经网络
- 客户端计算:部分处理在手机端完成,不依赖云端
评分的可信度
- 你第一次可能觉得 AI 评分不准——这很正常。建议在安静环境下、麦克风效果好时再试
- 同样一个词,同样的嘴型,AI 评分可能上下浮动 5~10 分,是正常的波动范围
- 关键是趋势:你练了一周后,红色音素变成黄色、黄色变成绿色,这才是最重要的信号
AI 不会做什么
AI 评分有几个明确的局限:
- 不会判断你说的是不是正确的单词——如果你把 think 说成了 sink,AI 可能会给 sink 的每个音素打分,然后发现跟目标(think)不符
- 不会判断你的音量和语速——它只关心音素本身的准确率
- 不会给出纠正动作的具体指导——"/θ/ 发不好" 是 AI 告诉你的,"怎么改" 是教练视频课教你的
两者配合才是完整循环:AI 告诉你哪里有问题 → 视频课教你怎么改 → 改完再让 AI 打分验证。